Claude Code 模型怎么选?Opus、Sonnet、Fable 与 Effort 完整选择指南
Choosing a Claude model and effort level in Claude Code
本文为 Claude by Anthropic 官方博客完整中文译文。版权归原作者及 Anthropic 所有;如译文与原文存在差异,请以英文原文为准。
模型选择的工作原理
当你按下回车键时,Claude Code 会将你的消息与系统 Prompt、工具定义、你的 CLAUDE.md、对话历史记录以及 Context 中的所有文件组装到一起。所有这些内容会作为一个请求发送给 API。
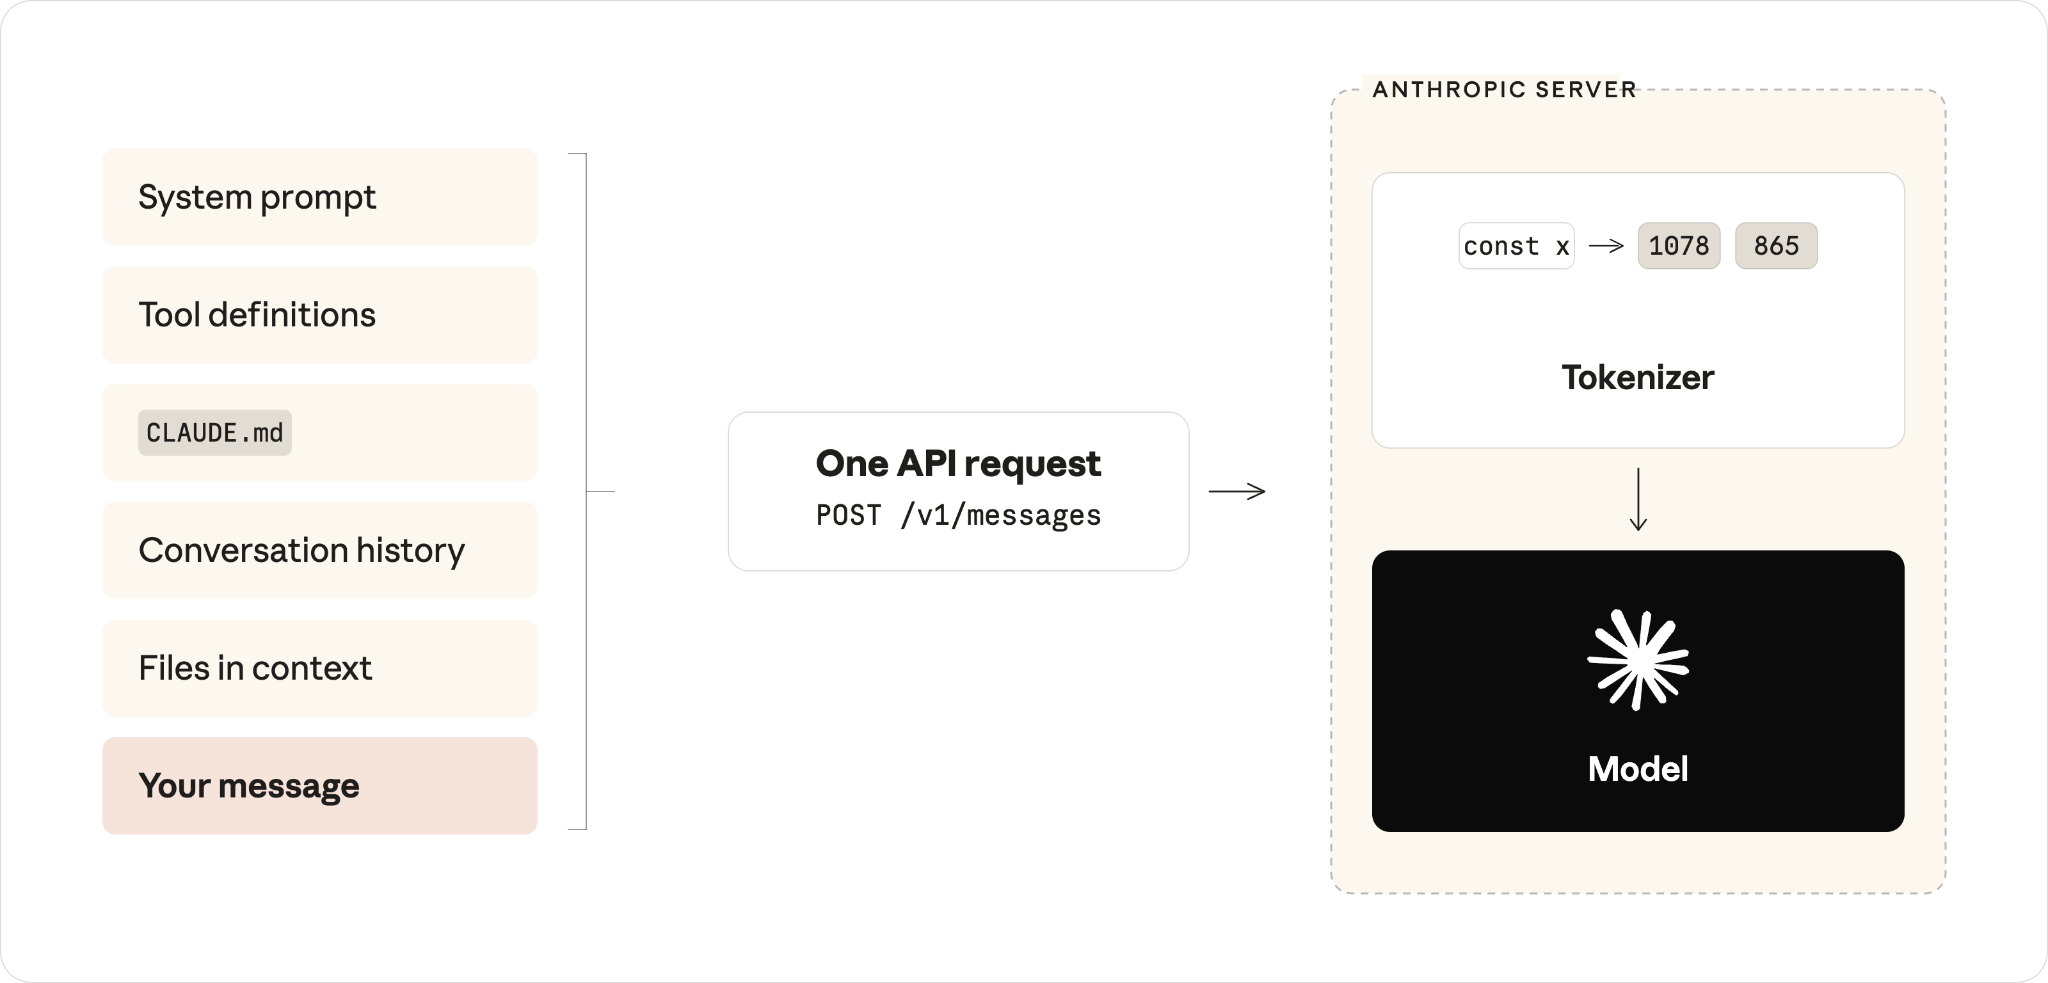
Claude Code 拥有的所有内容都会被打包到一个 API 请求中。在服务器端,文本会先被 Token 化,然后才会抵达模型。
不过,模型看到的并不是纯文本。服务器首先执行的是 Token 化:文本会被拆分成若干片段,每个片段都会映射到模型训练时所用固定词表中的一个整数。const 可能映射为 1978,await 可能映射为 4293。从这一步开始,你的 Prompt 就成了一个整数数组。
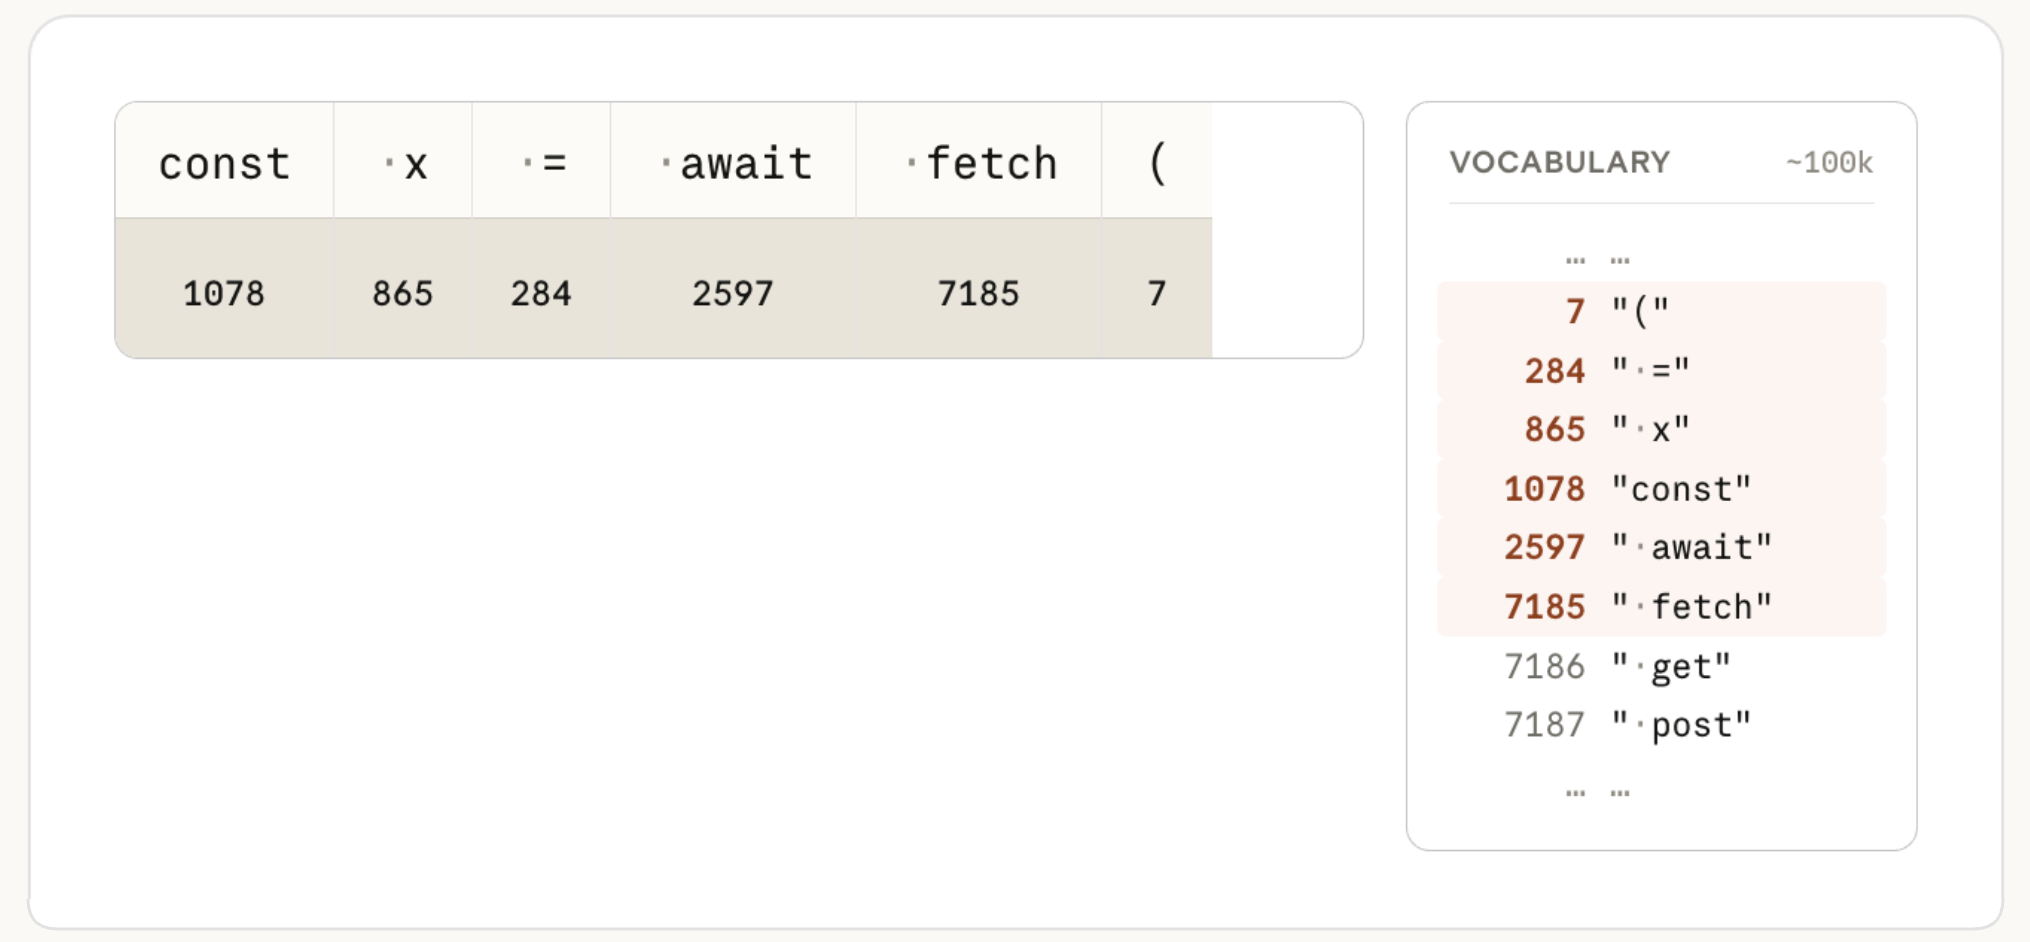
Tokenizer 会将文本拆分成片段,并把每个片段映射到固定词表中的一个整数。顶行中的每个文本块都会转换成对应的 Token ID(底行);图中所示 ID 仅供说明。
模型的任务是接收这个数组,并预测下一个 Token 是什么。它会为词表中的每个 Token 计算一个概率,然后从概率最高的候选项中进行选择。在 const x = await 之后,训练良好的模型会为 fetch 分配很高的概率(极有可能),而 banana 的概率则接近于零(几乎完全不可能)。
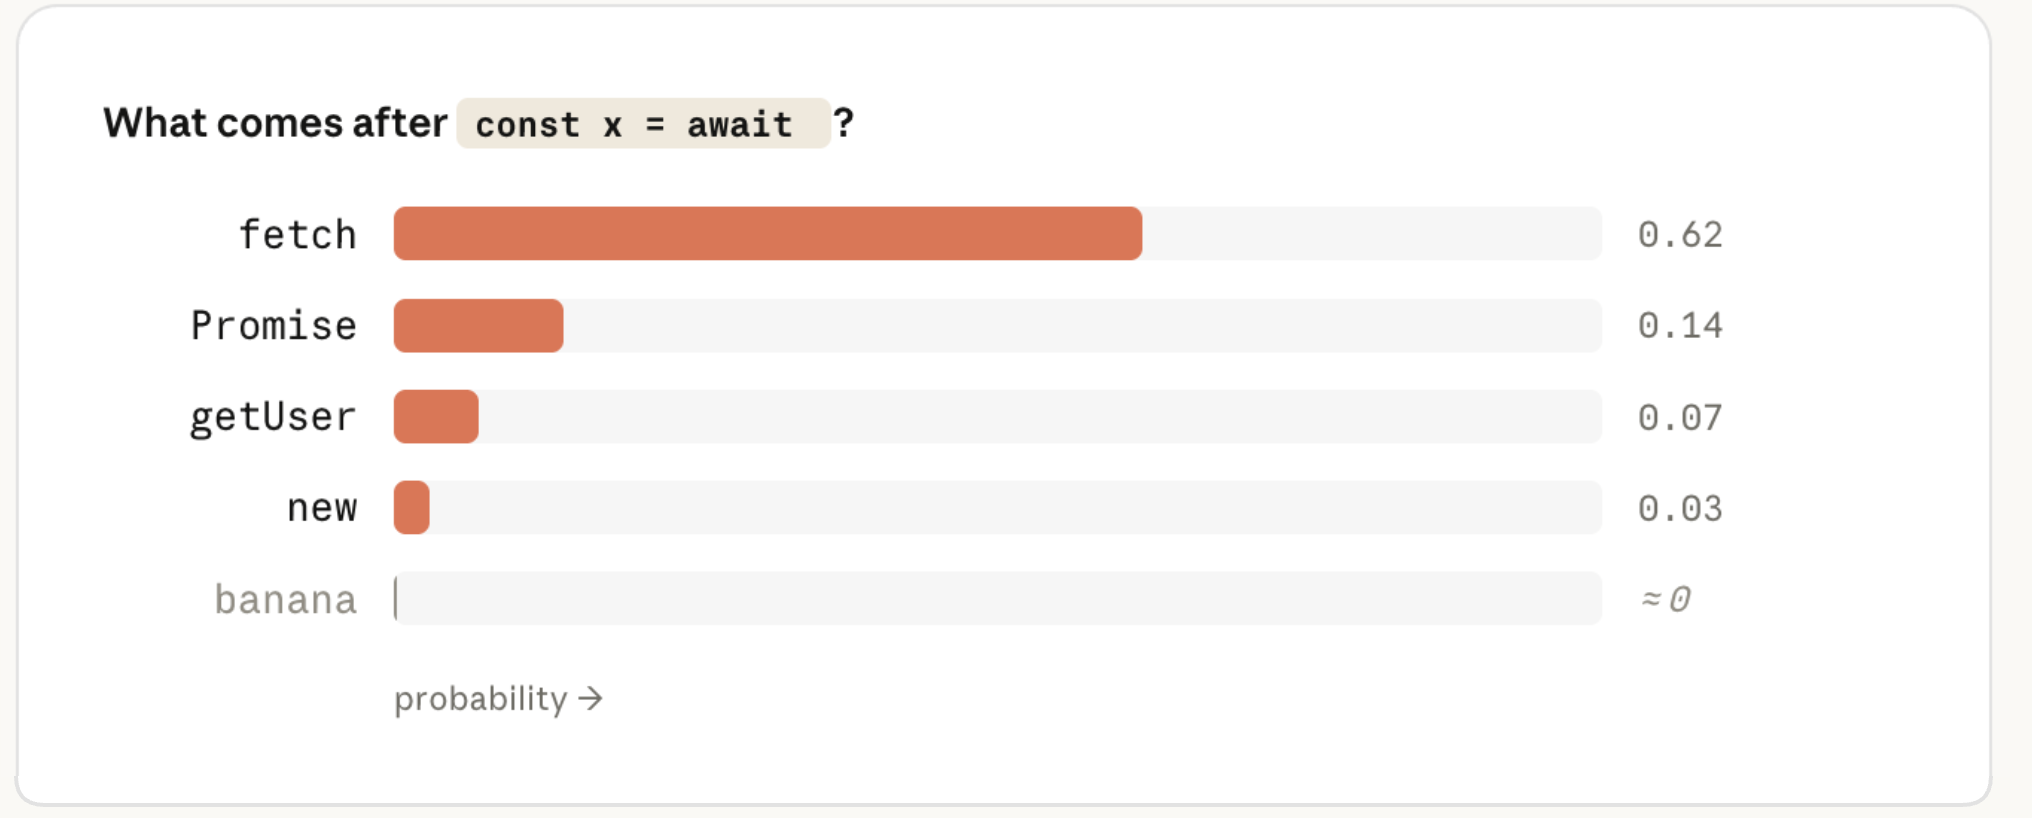
模型会为词表中的每个 Token 预测一个概率。概率最高的猜测与毫不相关的猜测之间存在巨大差距。
将输入 Token 转换为这些概率的是权重(也称为参数)。权重是数十亿个组织成大型矩阵的数值。为了预测一个 Token,模型会让输入经过这些矩阵,执行一长串矩阵乘法,并在最后读取所得概率。模型“知道”的一切都存在于这些权重中。
**每个模型的权重都在训练期间确定;等到你发送请求时,它们已经是只读的。**你的 Prompt、CLAUDE.md 或 Context 中的任何内容都无法改变它们。(如果你见过 inference 这个词,它的含义仅此而已:在训练完成后、权重固定的情况下使用模型。)
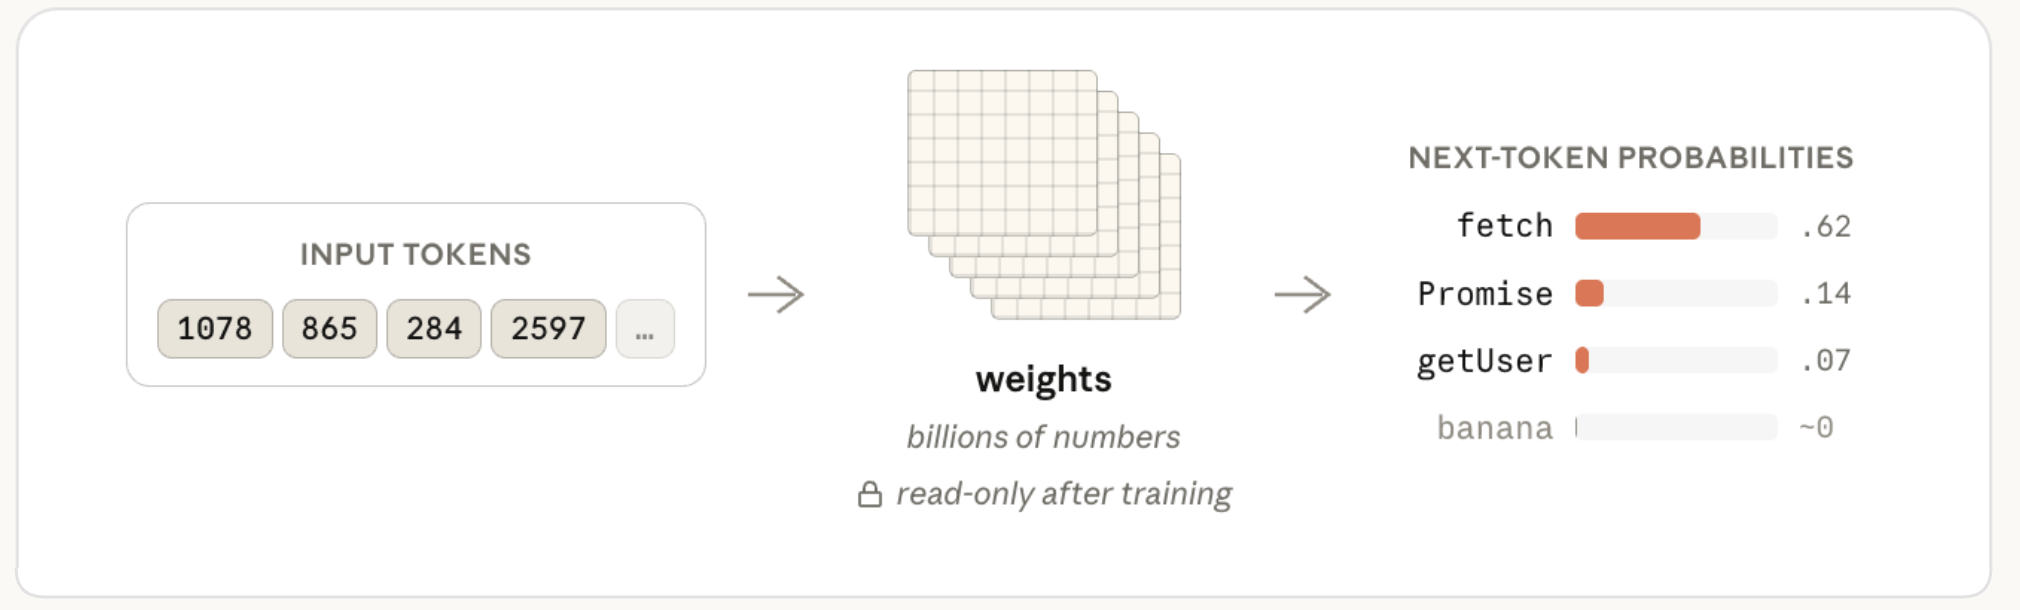
输入 Prompt,输出概率。位于中间的权重不会改变。
Claude 掌握的关于 TypeScript、热门框架、地道 Go 写法或其他任何通用编程知识,全都是在训练期间编码进这些权重的。
你的 Prompt 和 Context 仍然可以引导预测(把真实代码放到 Claude 面前就是一种引导,而且非常有效),但它们不会向权重本身添加任何内容。
如果某个库在模型训练时还不存在,它就不会存在于权重中。你可以把文档放入 Context,Claude 也会使用它们,但这属于引导,而不是教学。Claude 的回答只会在该次请求中受到这些信息的影响;底层模型并不会保留这些信息。
因此,当 Claude 自信地调用了一个并不存在的 API(即幻觉)时,实际发生的是:权重根据训练模式生成了一段看起来合理的 Token 序列,而不是查询失败。
那么,更换模型实际上改变了什么?它会替换掉处理请求的那一组冻结权重。
模型不会一次性生成完整答案。它会预测一个 Token,将其追加到序列中,然后再次运行完整计算来获得下一个 Token。一个包含 200 个 Token 的回答,需要分别经过权重执行 200 次计算。你的大部分等待时间和输出费用都来自这个循环。
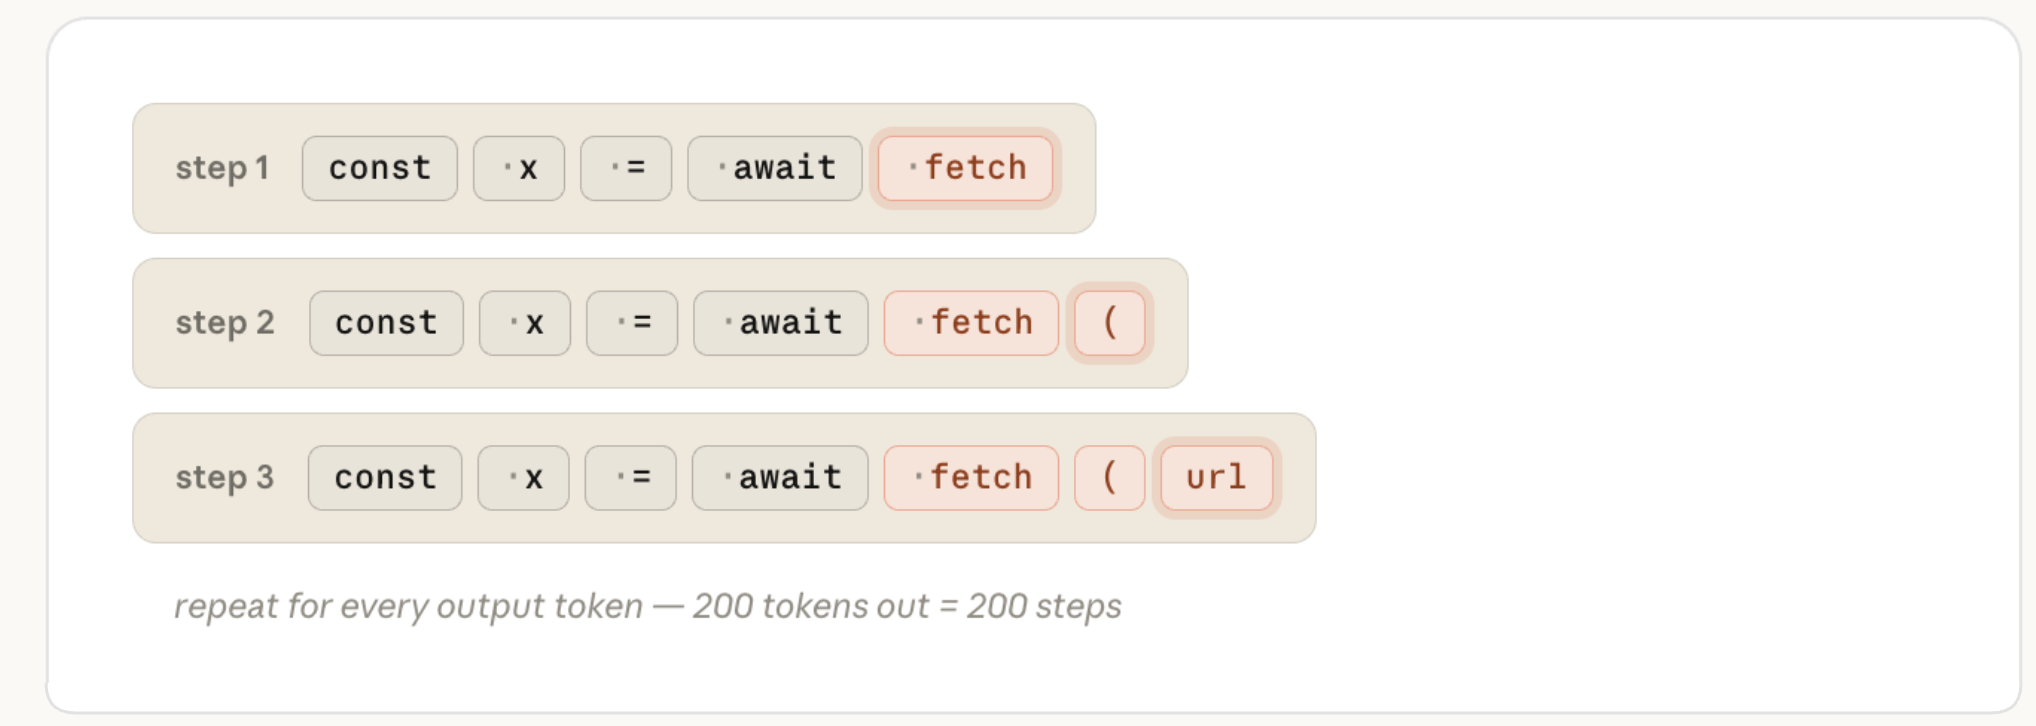
序列每一步恰好增长一个 Token。模型每次都会重新读取整个数组,以预测接下来会出现什么。
因此,模型设置决定由哪组权重处理你的请求,也决定每个输出 Token 的费用。
它不决定生成多少个 Token。即使 Prompt 相同,这个数字也可能有很大差异,具体取决于 Claude 决定投入多少工作。
这正是 Effort 级别所控制的内容:Claude 决定为每一轮投入多少工作。
Claude Code Effort 级别的工作原理
Claude Code 执行任务时,生成的 Token 分为以下几类:
- 思考:你在操作之前和操作之间看到的流式推理内容。
- 工具调用:包含 Read 或 Edit 等工具名称及其参数的结构化块,随后由 Claude Code 解析并执行。
- 发给你的文本:计划、进度更新以及最后的总结。
这些全都是同一循环生成的普通输出 Token,并按相同费率计费。例如,思考 Token 的生成方式与其他输出 Token 完全相同,并且会在该轮对话剩余过程中保留在 Context 中。
当 Claude 开始编写代码时,它先前的推理就像它读取过的文件一样,成为输入的一部分。
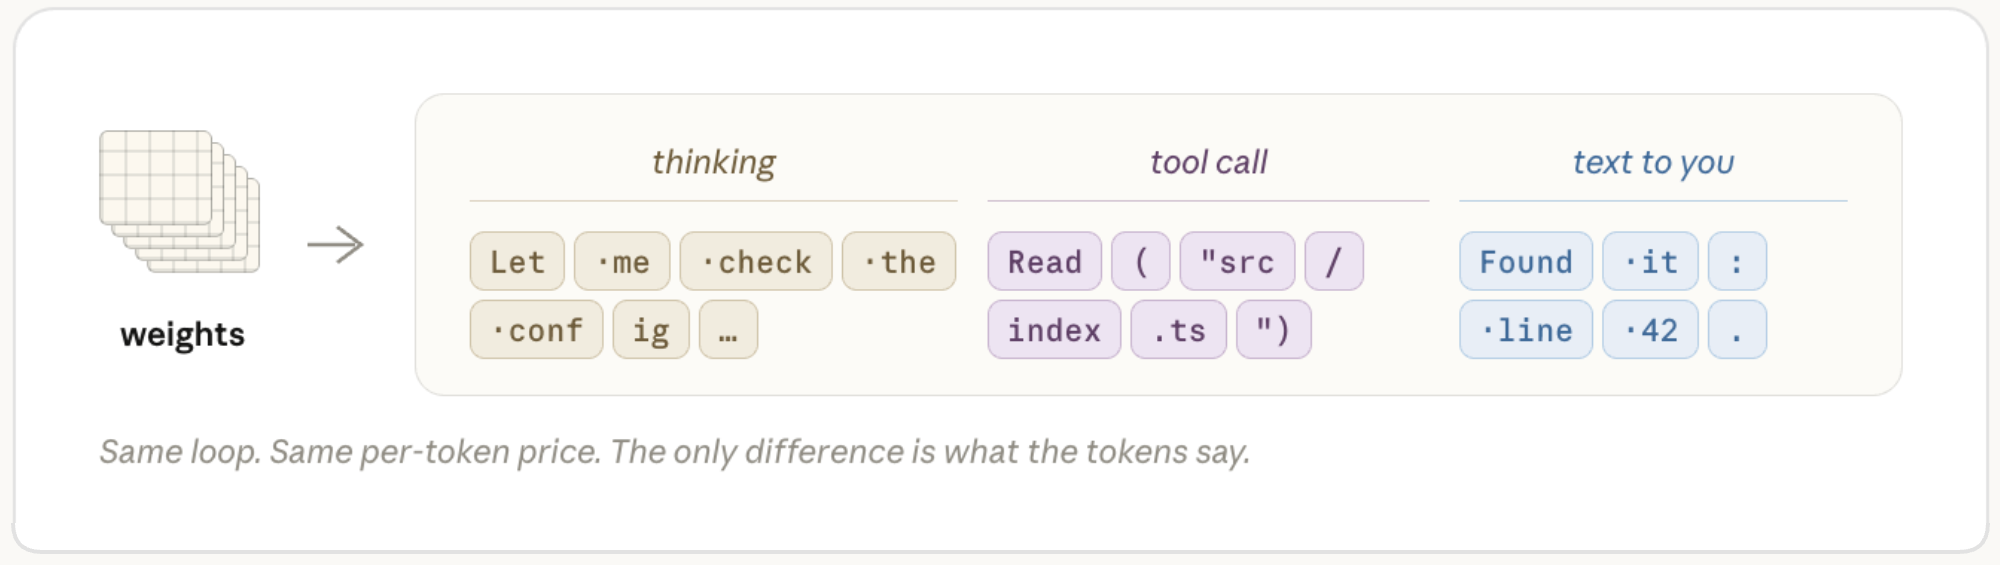
Claude 的所有输出都是 Token。思考、工具调用以及发给你的文本都由同一个循环生成。
Effort 如何改变这一切?Effort 级别会与 Prompt 一同作为请求的一部分发送给模型。模型接受过训练,知道在每个 Effort 级别下应当如何行动,而这种学习到的行为已经固化在冻结权重中。
当请求抵达时,Effort 级别只是模型需要响应的另一项输入,就像它会响应你的 Prompt 文本一样。它会设定 Claude 的行为方式,决定 Claude 在认为任务完成之前需要做到多么全面和确定。
Claude 会在每一轮都考虑这一点,其结果是通过生成更多 Token 来产出置信度更高的答案。
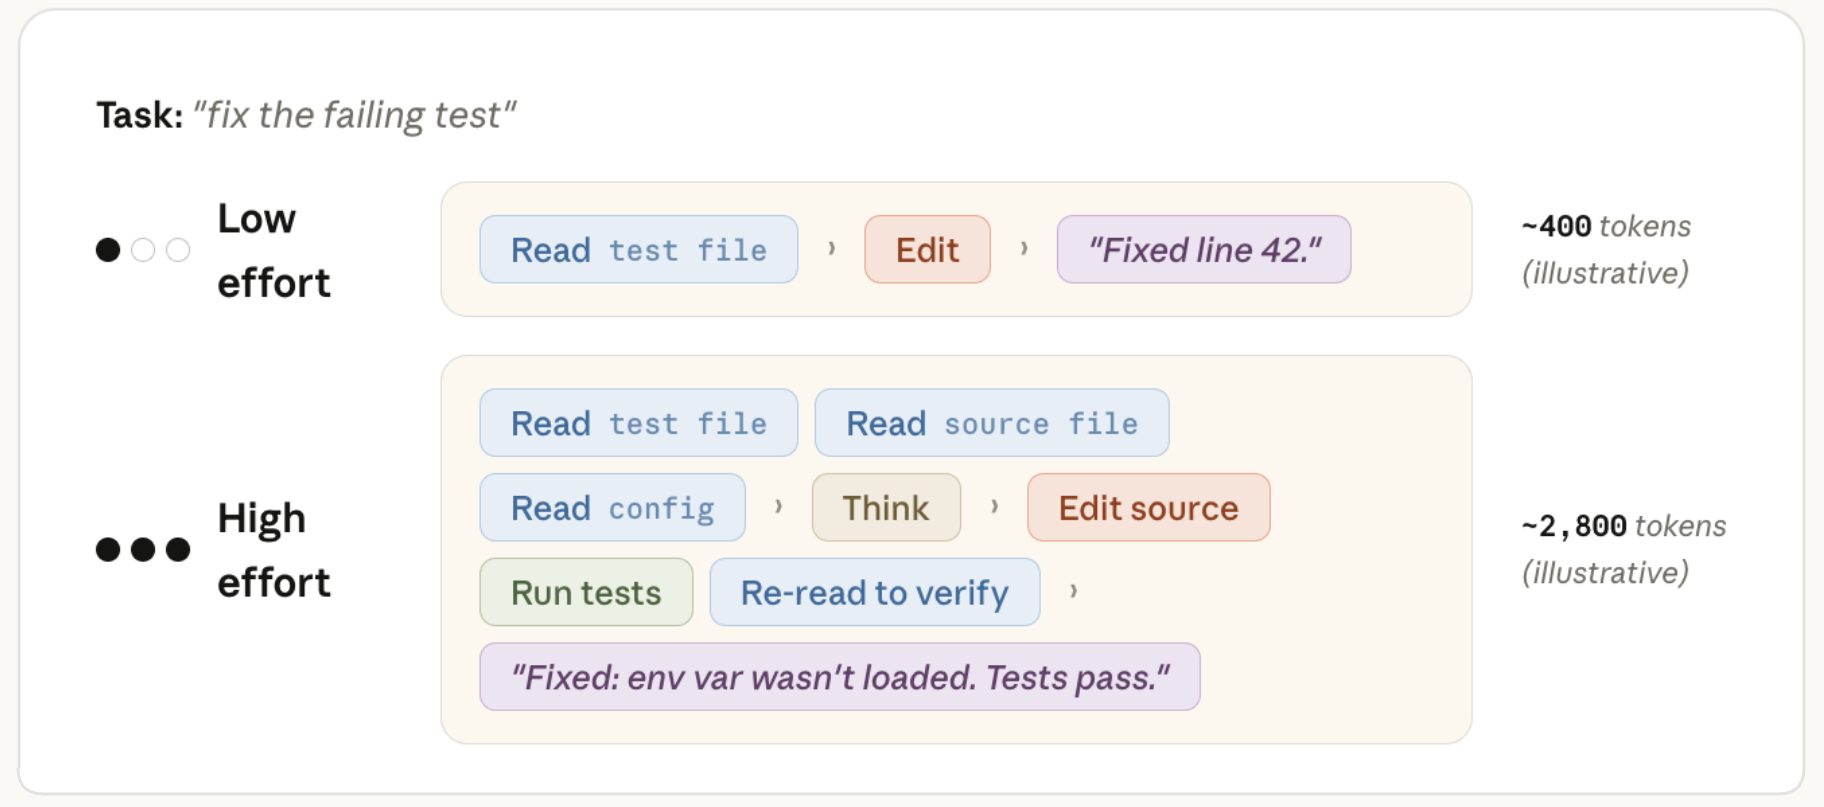
相同的 Prompt,两种 Effort 级别。high Effort 路径生成的 Token 大约多 7 倍,从而得到置信度更高的答案。
在较高的 Effort 级别下,Claude 通常会先制定计划,而 Effort 级别会影响计划的深度和广度。不过,这份计划并非一成不变。随着 Claude 收到操作结果,它会更新已经取得的进展,以及自己对累积结果的确定程度。
因此,如果一个包含三项假设的调试计划在第 1 步就找到了 bug,那么“调查假设 2 和 3”可能不再是必要操作。Claude 通常会明确说明这一点,例如“第一次检查就找到了问题,因此不需要再进行剩余检查”,然后直接跳到后续步骤。当 Claude Code 在执行过程中修改任务列表时,你看到的正是这种情况。
在较高的 Effort 级别下,Claude 会更倾向于复查额外假设或验证正确性,但即使处理简单任务,它通常也不会为了提高用量而刻意增加工作。事实上,我们的团队在模型训练期间会密切关注“过度思考”,因为它会降低有效性。
选择 Effort 级别
我们的建议是:对于大多数任务,都应该使用模型的默认 Effort 级别。在默认级别下,Claude 会根据大多数人愿意在一项任务上投入的成本来调整 Token 用量。
你可以把 Effort 看作一个手动覆盖选项,用于调整 Claude 工作的强度和时长。当你基于自己的领域或工作类型,对全面性或速度有明确偏好时,可以有意识地选择它。相比逐项任务做决定,更适合把它当作一种总体偏好。
在 Claude Opus 4.8 发布后,下面这条实用见解或许能帮助你做出选择:在我们的测试中,对于同一项任务,使用 Opus 4.8 的默认 Effort 设置,与使用 Opus 4.7 的默认 Effort 设置相比,消耗的 Token 数量大致相同,但结果更好。
Claude 出错时应该调整什么
当 Claude 出错时,你的第一反应不应该是调节某个旋钮,而应该检查自己提供的 Context。你的 Prompt 是否过于模糊?Claude 是否连接到了正确的工具?是否配备了正确的 Skills?
如果你正在为一项本来不应该需要更高 Effort 的任务提高 Effort,那么问题通常出在上游:你的 Context、CLAUDE.md,或任务范围的划分方式。
不过,假设你已经提供了清晰的 Context,而 Claude 仍然出错,那么你应该问自己:它是没有足够努力,还是没有足够的能力或知识?
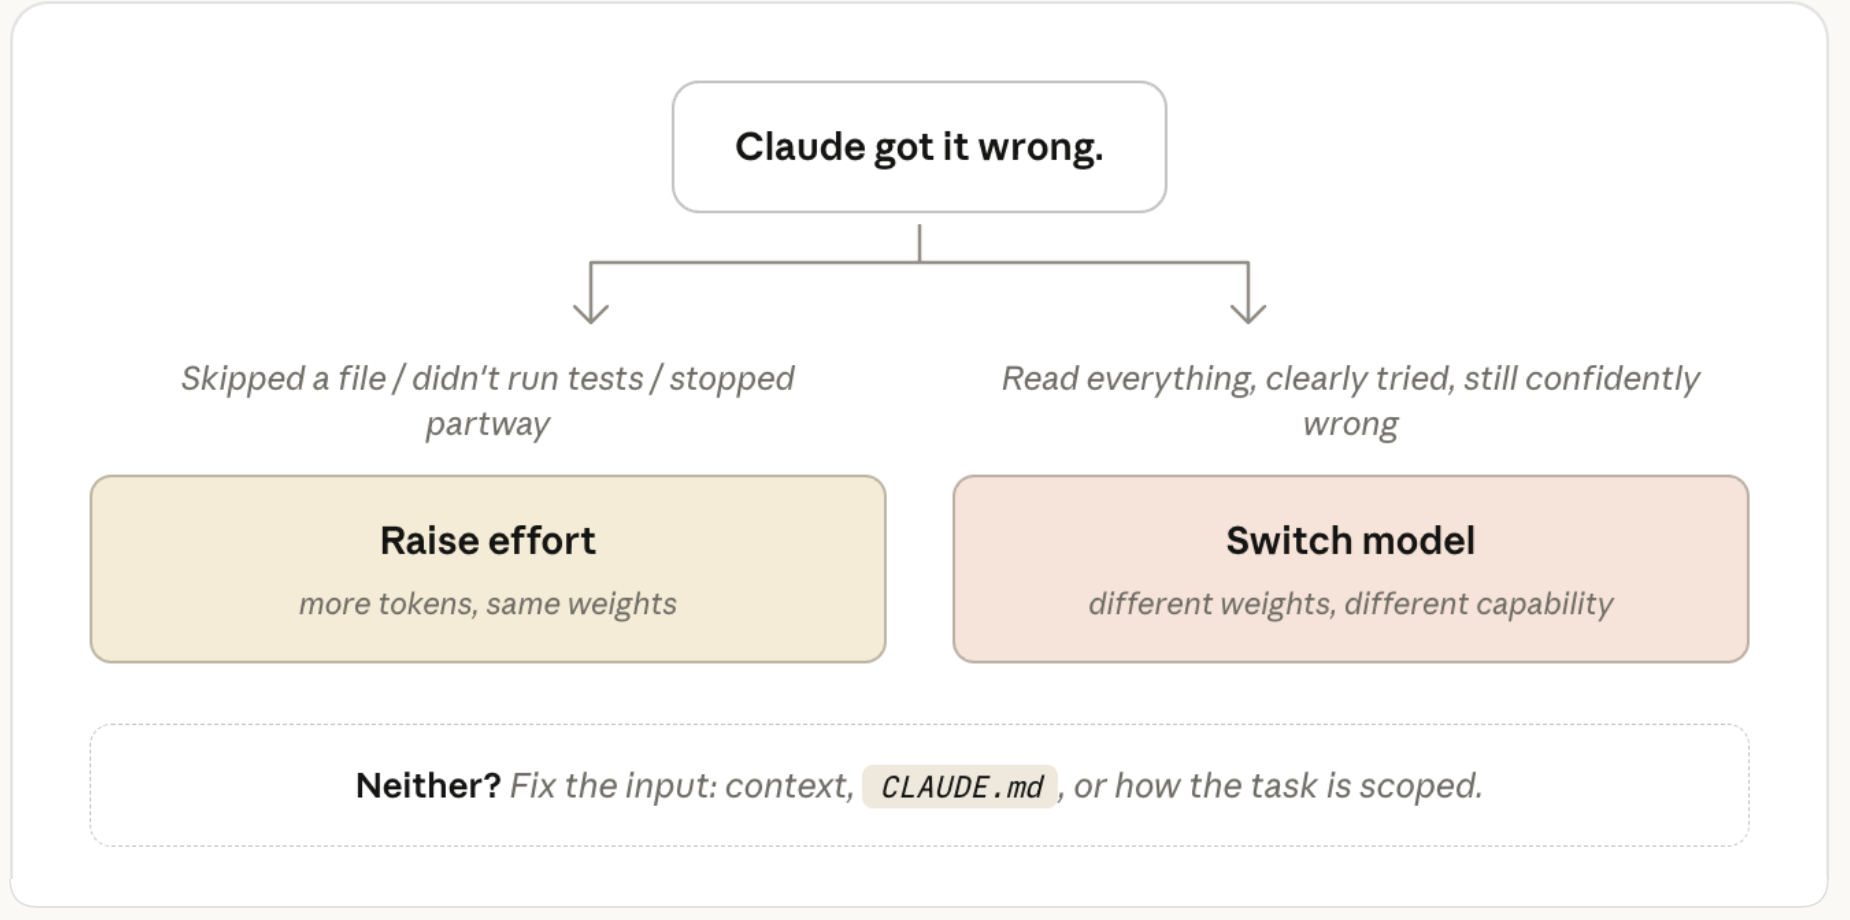
两个问题,一种兜底方案。将这套启发式方法作为选择起点,而不是硬性规则。
模型:问题难度太高
当问题确实很难时,应选择更大的模型。例如隐蔽的 bug、不熟悉的领域或架构决策。如果无论你提供多少 Context,较小的模型都会自信地给出错误答案,那么更大的模型会很有帮助。
更大的模型也更擅长处理歧义;而对于较小的模型,通过具体指令明确指导执行过程,更容易取得成功。
当工作比较常规时,应选择较小的模型。例如可以精确描述的编辑、机械性修改,或有关已经位于 Context 中的代码的问题。没有理由为任务并不需要的能力付费。
如果 Claude 已拥有所有相关 Context,显然也认真尝试过,但依然答错,这就是应该选择更大模型的信号。如果你正在使用较大的模型,而近期工作一直比较常规,那么切换到较小的模型可以提高速度,通常也能降低成本,同时不会影响输出质量。
Effort:Claude 不够努力
如果 Claude 因为漏看文件、没有运行测试或没有复查自己的工作而出错,请选择更高的 Effort 级别。如果你选择的 Effort 级别低于模型默认值,这一点尤其适用。
Fable、Opus 与 Sonnet:专家型人才、资深专家和通才
我喜欢用这种方式理解这两项设置之间的关系:Fable 是一位见过几乎无人遇到过的问题的专家型人才,Opus 是资深专家,而 Sonnet 是一位非常优秀的通才。Effort 级别决定他们中的任何一位会在你的任务上花费多少时间。
采用 low Effort 的 Opus,就像获得与一位在同类问题上拥有深厚经验的专家交流五分钟的机会。他们能带来代码库中根本不存在的知识:以前见过的模式、知道需要检查的陷阱,以及只有解决过大量类似问题才能积累的经验。不过,只给他们五分钟,意味着他们只能快速浏览你的代码,而无法仔细阅读。
采用 high Effort 的 Sonnet,就像让一位非常优秀的通才用整个下午来处理问题。他们会阅读所有内容、运行程序、复查自己的工作,最终彻底理解你的这份具体代码。他们相对欠缺的是那种“我以前见过一模一样的问题”的识别能力。
Fable 即使采用 low Effort,也像是那位专家型人才扫了一眼其他所有人都束手无策的问题,仍然发现了无人察觉的关键。你支付的最高费用主要就是为了这种识别能力,因此值得把它留给真正需要它的任务。
这些选择没有任何一个在所有情况下都更好。模型设置大致决定能力有多强;Effort 设置大致决定工作有多全面。大多数真实任务对两者都有一定要求。
Effort、模型与 Token 消耗
那么,模型选择、Effort 和 Token 消耗之间究竟如何相互影响?这取决于任务。
对于相同 Effort 级别下的常规工作,两种模型通常都能正确完成。较大的模型会执行额外的验证步骤,从而消耗更多 Token,而且每个 Token 的价格也更高。因此,在长时间处理常规工作时切换到较小的模型,可以在不损失质量的情况下切实节省费用。
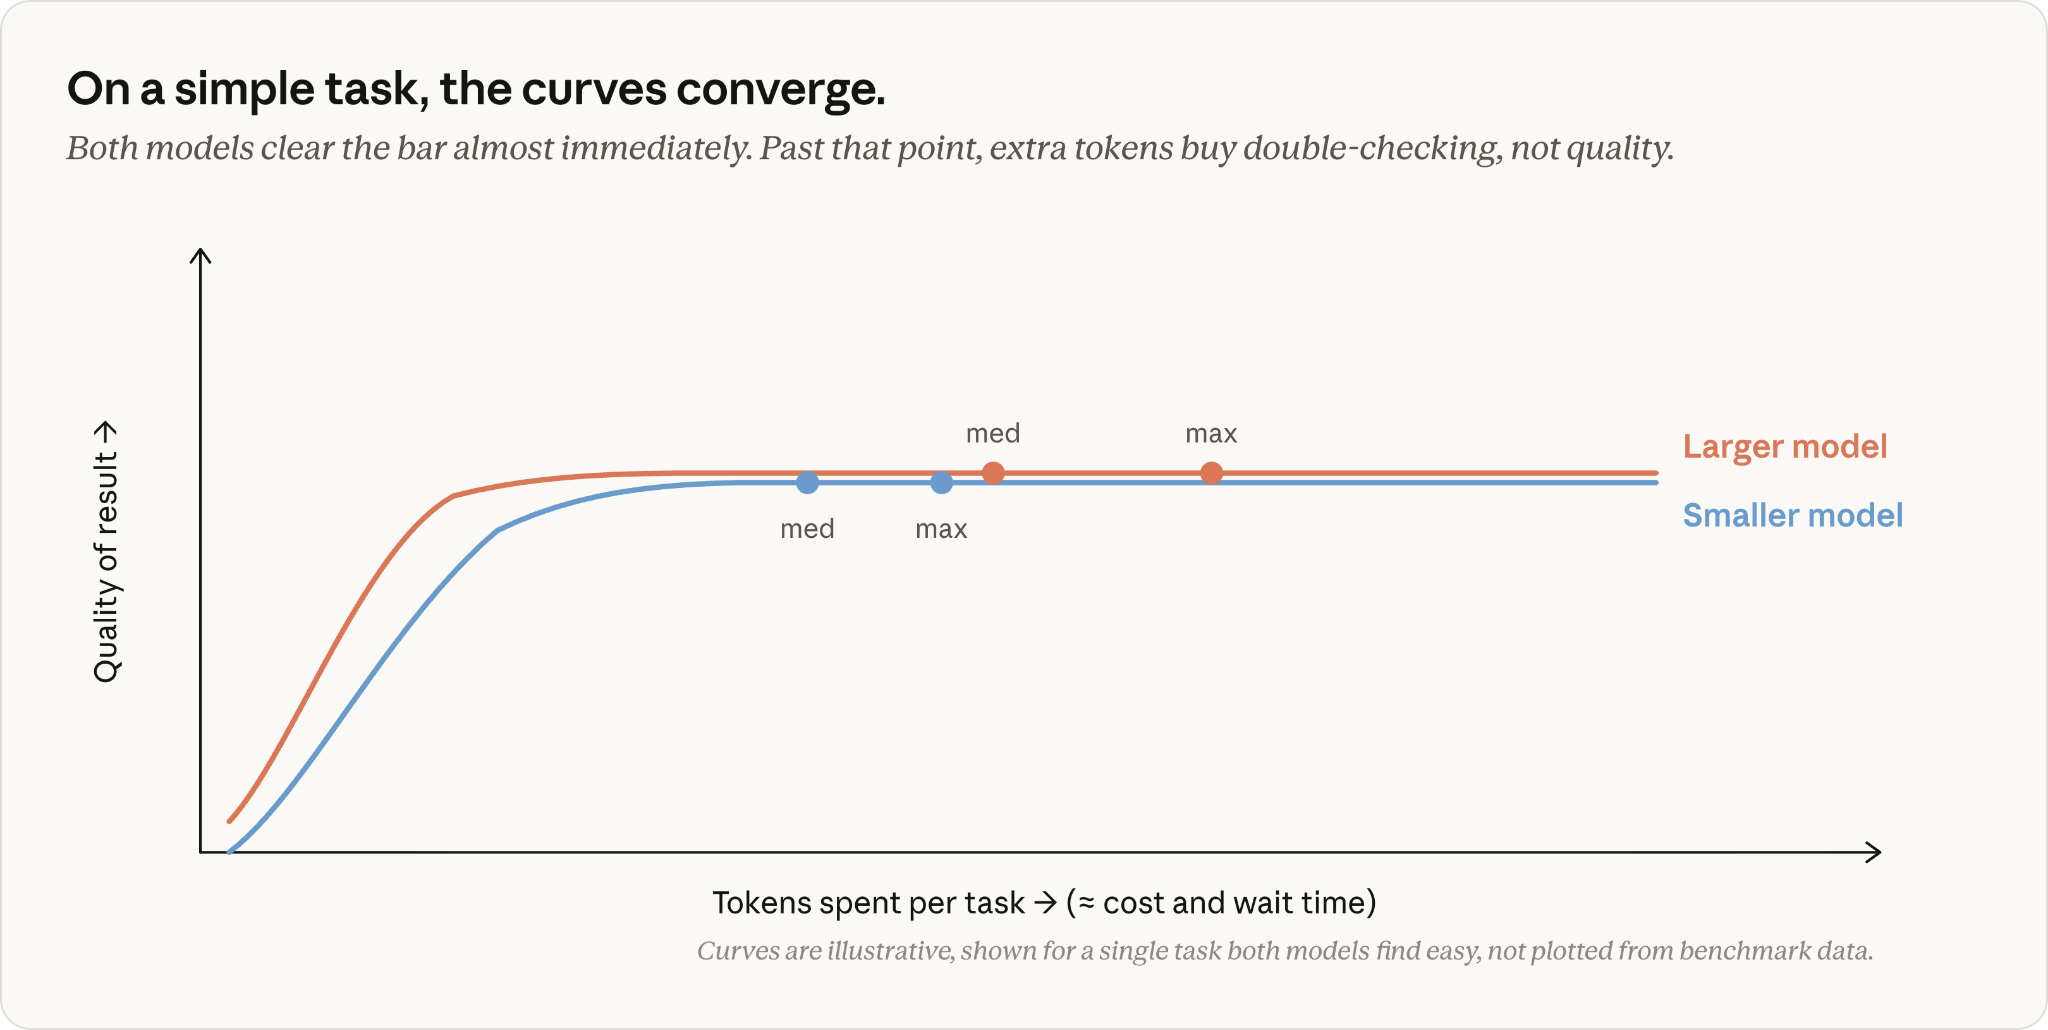
曲线仅用于说明,展示的是一项简单到两种模型都能迅速完成的任务。它们并不代表真实的基准测试数据。
对于难度更高、包含多个步骤的工作,情况则有所不同。较小的模型必须在能力极限附近艰难推进,消耗大量迭代,而较大的模型只需更少步骤就能达到同等质量标准。
使用较大的模型时,每个 Token 的费用更高;但对于确实会让较小模型面临能力极限的任务,较大模型的单项任务总成本反而可能更低。更重要的是,较大的模型可以完成一些较小模型即使采用最高 Effort 设置也无法完成的任务。
这一点在 Fable 上最为明显。在耗时较长、包含多个步骤的工作中,它的领先幅度最大。在我们的测试中,它完成了 Opus 和 Sonnet 在任何 Effort 级别下都无法完成的任务。它的每 Token 成本也是最高的,这也是应该把它留给真正需要这类能力的工作的另一个原因。
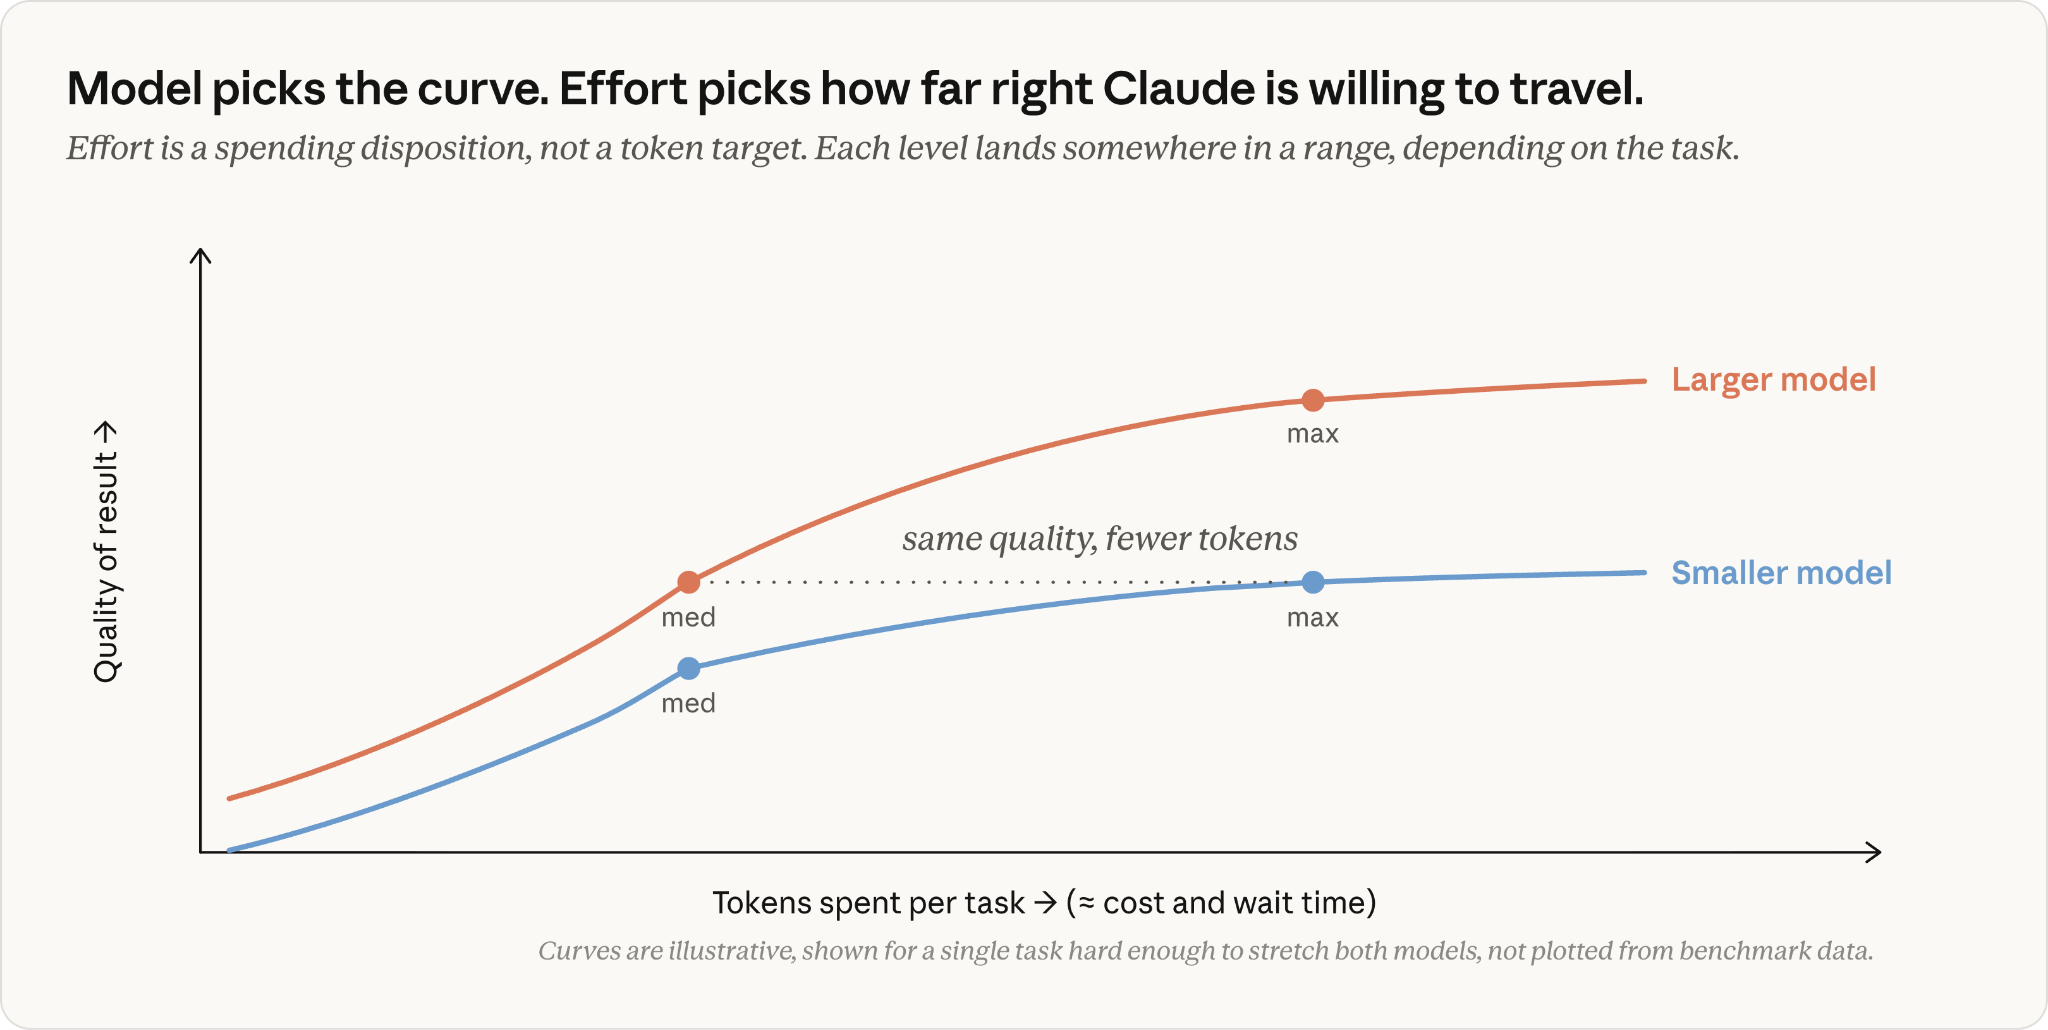
曲线仅用于说明,展示的是一项难度足以让两种模型都接近能力极限的任务。它们并不代表真实的基准测试数据。
上图的关键在于,Effort 级别决定 Claude 愿意在曲线上走多远;但再次强调,这并不意味着 Claude 为了完成任务一定需要走那么远。
这里还有一个细微之处:Effort 会影响 Token 消耗,但不会限制它。系统中唯一的硬性上限是 max_tokens,达到该上限时,回答会在输出过程中被截断。这是一种比较生硬的手段,主要与 API 开发者相关。更柔性的控制方式会更有帮助,例如任务预算,或在 Prompt 中要求 Claude 保持简洁。这些方式属于模型在训练中学会遵循的指导——如果接近限制,它会设法结束任务——而不是一堵会让模型直接撞上的墙。
从默认设置开始,再按需调节
大多数时候,你都不需要考虑这两项设置中的任何一项。当结果没有达到预期时,请问:“Claude 是能力或知识不足,还是不够努力?”然后根据需要进行调整。
如需了解专门用于提升效率的完整技巧,请参阅最大化 Claude Code 会话的价值。
本文由 Claude Code 团队技术人员 Lydia Hallie 撰写。