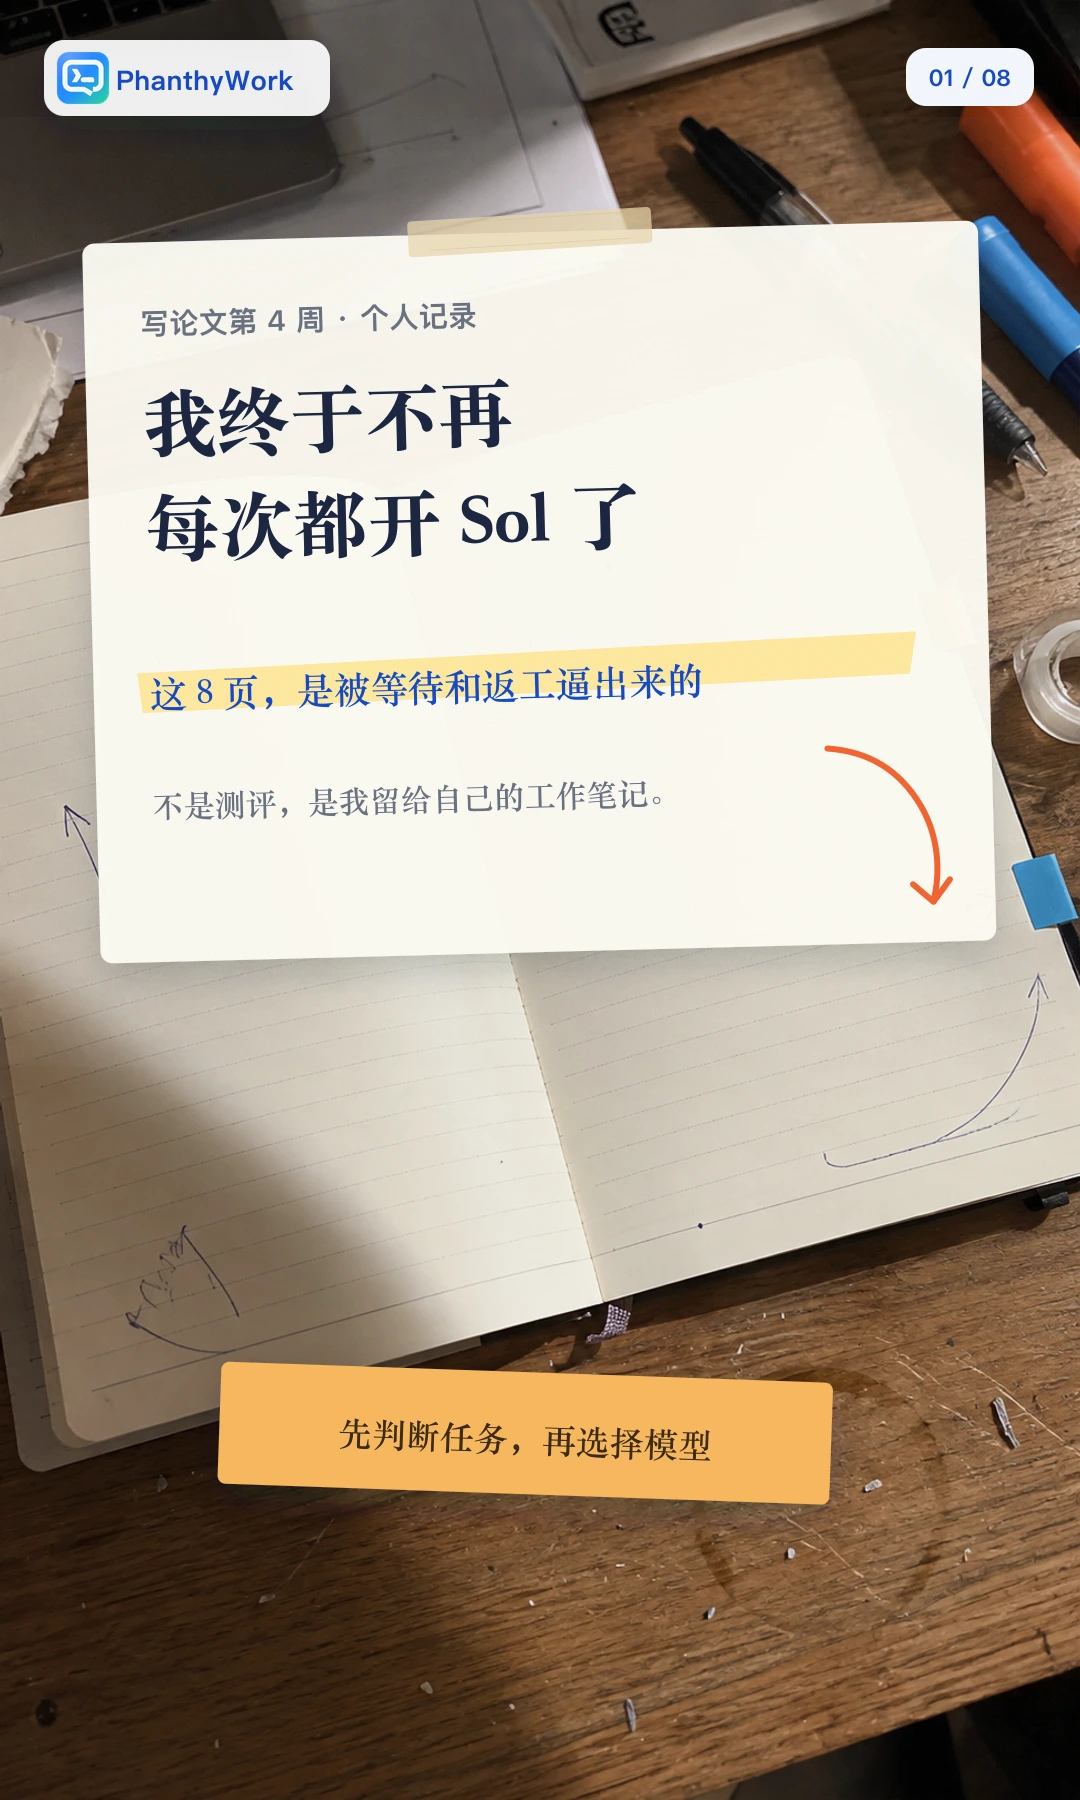
我终于不再每次都开 Sol 了
用真实手记的口吻记录从无脑开最高档,到按任务选择 Luna、Terra、Sol 的论文工作流。
- 适合谁
- 已经在论文工作中使用 AI、但经常不知道如何选择模型和思考强度的研究生
- 图片素材
- 8 张待 Review
- 文案版本
- 2 个可复制版本
这篇只讲清楚一件事
这篇先给你看什么
一套像真实研究笔记与备忘录截图的八页模型选择记录,最后留下可以贴在电脑边上的任务公式。
实际怎么完成
先记录无脑开最高档造成的等待与返工,再用任务难度和可验收性判断模型;按 Luna 清杂活、Terra 推进论文、Sol 解决卡点分工,并在 PhanthyWork 中保留材料、过程和交付物。
发布前要核对
这是个人使用记录,不是模型能力评测;发布前确认客户端模型名称,所有论文引用、数据、分析结论和署名仍须由作者本人核对。
逐张检查组图,再确认发布文案
首轮发布素材已经生成;可以逐张预览、单独下载,并结合取证提示补入正式产品截图。
我终于不再每次都开 Sol 了
正文写论文第 4 周,我终于把一张模型选择便签贴在了电脑边上。 前两周我用得挺笨的。只要和论文沾边就开 Sol + 高思考:扫摘要开,查报错开,连给导师改一句邮件也开。最直接的后果就是等。有天晚上我只是想把 Dear Professor 后面一句话改顺,盯着进度条看了半天,突然觉得自己这用法有点离谱。 后来我也没再研究参数,而是在本子上写了两个问题:这一步只是想赶紧做完,还是值得我自己想半小时?结果出来以后,我能不能马上检查它对不对? 现在翻译、格式、导师消息和实验日志这些能立刻核对的活,我先给 Luna。要快速扫一批论文,就把思考开到中,先看看哪些真的值得读。 真正推进论文时,我用 Terra 更多。精读、看方法和代码、整理实验、改组会逻辑,大多中档就够。遇到“这个结果就是不对劲,但我说不出哪里不对”时,再开高一点,让它帮我列原因和验证顺序。 Sol 现在很少开。通常是 bug 查了两天还没头绪、结果明显反直觉、novelty 怎么都说不顺,或者 reviewer 真的问到了成立性问题,我才会用。 说实话,这套分法也不是每次都准。Luna 有时会漏掉摘要里的关键限制,Terra 分析异常结果也可能绕远,我还是会重跑。但和以前什么都开最高档相比,等待少了,自己也更清楚正在解决哪一步。 我现在会在 PhanthyWork 里给每篇论文单独建一个任务,把 PDF、实验表、代码和导师批注放在一起。中途换模型时不用重新讲一遍背景,这是我体感最明显的省事。最后的引用、数据和结论,我还是会自己逐项核对。 不是模型评测,就是最近真的这样在用。
标签发布前取证:这是个人使用记录,不是模型能力评测;发布前确认客户端模型名称,所有论文引用、数据、分析结论和署名仍须由作者本人核对。